
«Как ИИ-поиск упоминает мой бренд?» — этот вопрос всё чаще встречается в поисковых запросах экспертов и владельцев бизнеса, и не зря. Мы всё чаще ищем информацию о людях и брендах не через первые десять синих ссылок, а одним запросом в ИИ-поисковике. Он не просто находит страницы — он пересказывает их, обобщает, делает выводы и формулирует репутацию за секунды.
Я провела эксперимент: задала восьми разным ИИ-поисковикам — Mistral AI, GigaChat, Нейро от Яндекса, DeepSeek, Perplexity, ChatGPT, Claude и Gemini — один и тот же промпт: собрать полный отчёт о биографии, профессиональной деятельности и цифровом следе основательницы нишевого бренда. Личность героини я в этом материале намеренно не называю: цель эксперимента — не пиар конкретного бренда, а разбор того, как работает (и где ломается) машина, которая всё чаще формирует первое впечатление о нас.
Результат в цифрах
| Система | Нашла бренд? | Уверенность ответа | Уникальных источников |
|---|---|---|---|
| Mistral AI | Нет | — | 0 |
| GigaChat | Да | Высокая | 7 |
| Нейро (Яндекс) | Да | Высокая | ~10 |
| DeepSeek | Да | Высокая, с юр. реквизитами | 8+ |
| Perplexity | Да | Средняя, с оговорками | 10+ |
| ChatGPT | Да | Средняя, честно про низкую медийность | 4–5 |
| Claude | Нет | — | 0 |
| Gemini | Да | Высокая | 8 |
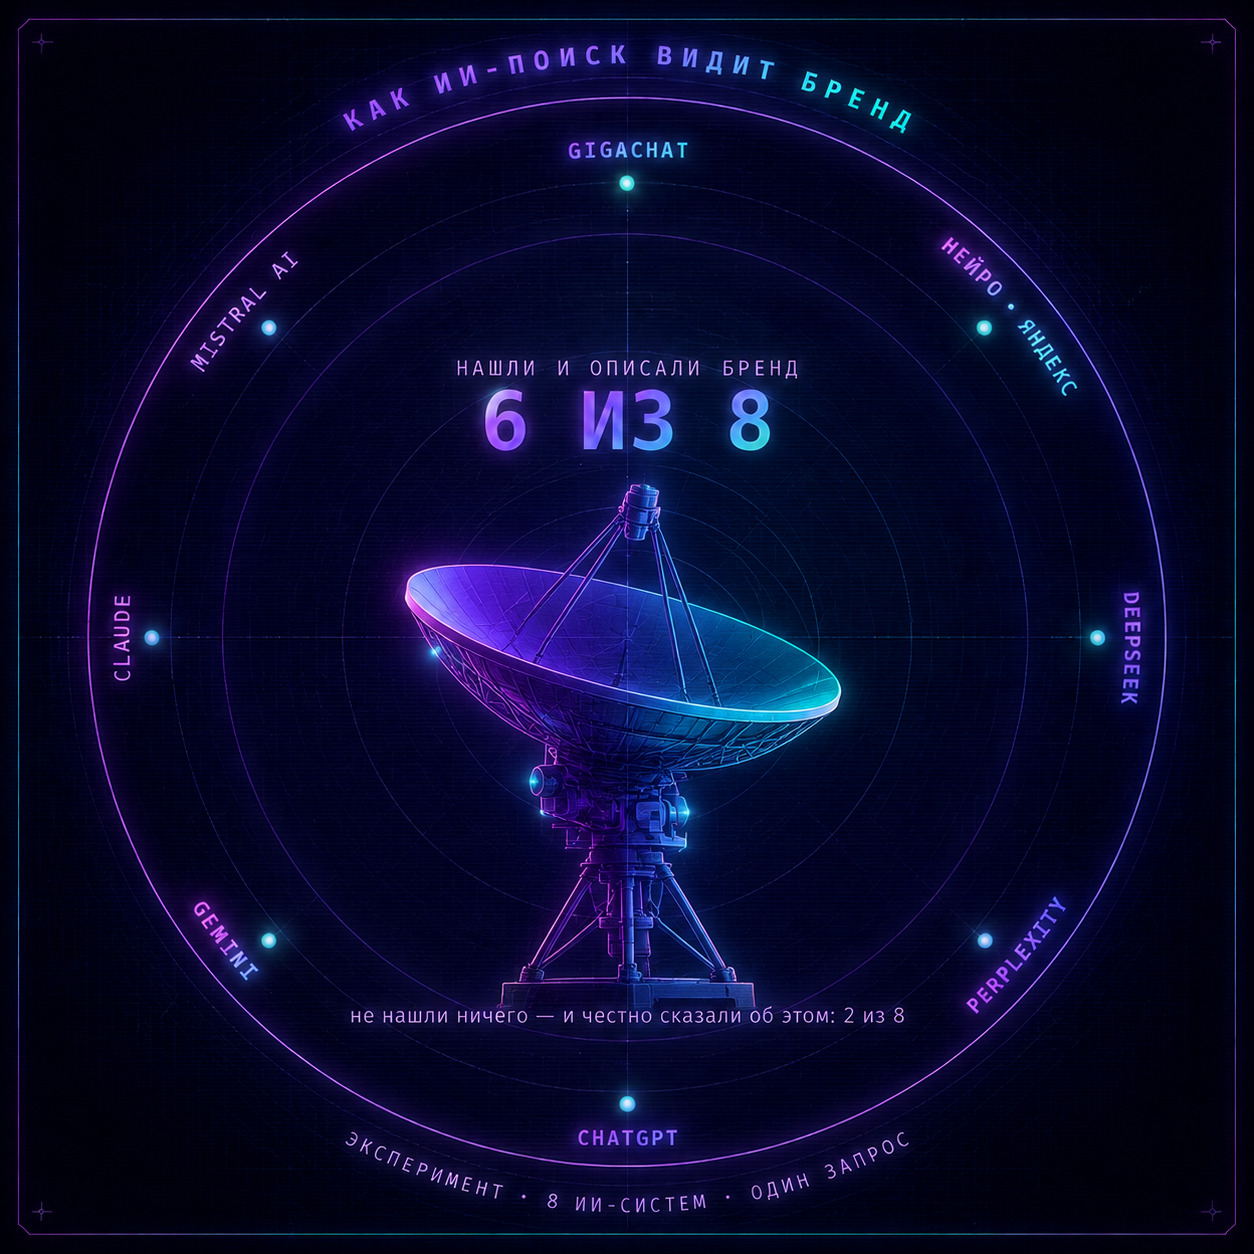
6 из 8 систем нашли бренд и дали развёрнутый отчёт. 2 из 8 — Mistral AI и Claude — прямо сообщили, что не нашли ничего, вместо того чтобы додумать ответ. Это первый вывод для любого, кто выстраивает медийность: наличие сайта, соцсетей, упоминаний в СМИ и подкастах не гарантирует, что вас увидят крупные ИИ-системы одинаково.
Из чего собран портрет: полная разбивка по доменам
Восемь систем в сумме сослались на два с лишним десятка доменов. Вот они все, без округления и обобщений.
Собственные площадки бренда
| Домен / площадка | Кем процитирован |
|---|---|
| Сайт бренда | 5 из 8 систем |
| Telegram-канал бренда | 4 из 8 систем |
| Профиль бренда в VK | 3 из 8 систем |
| Канала бренда в мессенджере МАКС (через сервисы аналитики mxstat.ru / maxometr.com) | 3 из 8 систем |
| Профиль бренда в Instagram* | 1 из 8 систем |
Отдельно один разговор на подкасте, растиражированный по разным площадкам — вот они все по отдельности:
| Домен / площадка | Формат | Кем процитирован |
|---|---|---|
| youtube.com (полная версия) | видео | 2 системы |
| youtube.com (шортс) | видео | 1 система |
| rutube.ru | видео | 2 системы |
| podster.fm | подкаст | 2 системы |
| soundstream.media | подкаст | 2 системы |
| music.yandex.ru | подкаст | 1 система |
| траектория-медиа.рф | статья с тезисами подкаста | 2 системы |
| tenchat.ru | статья с тезисами подкаста | 1 система |
| vk.com | анонс подкаста | 1 система |
| vk.com | статья с тезисами подкаста | 1 система |
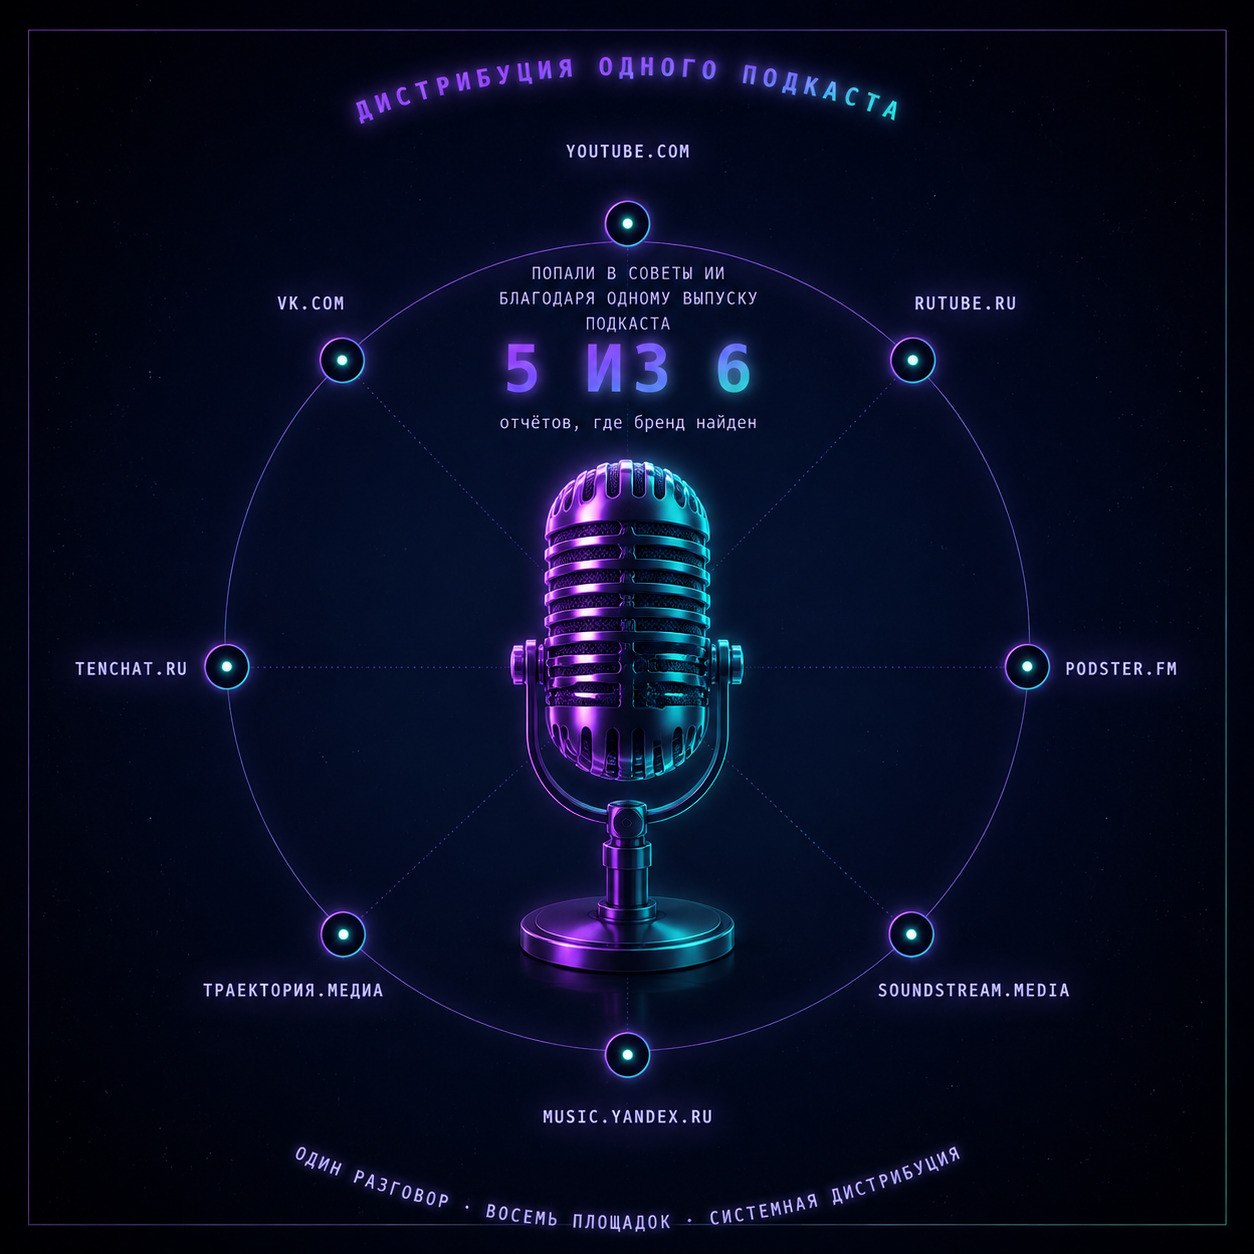
Это восемь разных площадок. Формально — восемь источников. Фактически — один записанный выпуск, размноженный по площадкам дистрибуции.
Другие независимые упоминания
| Домен / площадка | Что это | Кем процитирован |
|---|---|---|
| локальное отраслевое СМИ (упоминание в статье) | краткое упоминание в материале о продукте | 1 система |
| локальное СМИ, анонс форума | заметка об участии в мероприятии | 1 система (Gemini) |
| tenchat.ru, отдельный пост об итогах фестиваля | упоминание в контексте нацпроектов | 1 система (Gemini) |
| vk.com, паблик вуза | участие в образовательной программе | 1 система (Perplexity) |
Реестры и справочники
| Домен | Что это | Статус |
|---|---|---|
| rusprofile.ru | реестр ИП, реквизиты | Подтверждено, совпало у двух систем независимо |
| реестр юрлиц, карточка стороннего ООО с похожим названием | несвязанное юрлицо | Ошибочно включено в отчёт как потенциально релевантное |
| реестр товарных знаков | товарный знак постороннего лица | Ошибка атрибуции — знак не принадлежит героине |
Иллюзия многоканальности: восемь площадок — один разговор
Один эпизод подкаста был распространён по нескольким площадкам: полная версия на видеохостингах, короткие ролики, публикация на подкаст-платформах, отдельная разборная статья, анонсы и расшифровки в сообществе. Отсюда и взялись все восемь доменов из таблицы выше.
Для человека, который вводит имя в поисковик, это выглядит как широкое медийное присутствие — восемь разных ссылок на восьми разных доменах. Но с точки зрения независимой проверки факта это один информационный узел, а не результат того, что несколько разных редакций самостоятельно рассказали об эксперте. Именно поэтому большинство отчётов почти дословно повторяют одни и те же сюжетные детали и цитаты, а потому что нейросети процитировали разные копии одного и того же материала.
Для сравнения: независимых упоминаний, которые никак не связаны ни с самим брендом, ни с этим интервью, в выборке набралось всего четыре — и они разбросаны по разным системам почти без пересечений (каждое нашла только одна система из восьми). То есть реальная, по-настоящему независимая медийность на порядок меньше, чем восемь доменов подкаста.
Вывод здесь двоякий. С одной стороны, у ИИ-поиска нет встроенного механизма отличить «восемь источников» от «одного источника в восьми местах» — это системная уязвимость, о которой стоит помнить, оценивая любую AI-сгенерированную справку. С другой стороны — это же и практическая возможность: грамотно спродюсированный и правильно задистрибутированный подкаст способен в одиночку занять восемь строчек в источниках почти на всех крупных площадках, как и произошло с героиней нашего эксперимента.
Фактические ошибки: от спутанных однофамильцев до устаревшей индексации
ИИ-поисковики не просто по-разному расставляют акценты — они прямо ошибаются, причём ошибки разного типа и разной степени опасности.
Ошибка атрибуции по частичному совпадению текста. Одна из систем приписала героине эксперимента регистрацию товарного знака, который на самом деле принадлежит постороннему лицу — с другим отчеством и без отношения к рассматриваемому бренду. Причина очевидна: система нашла в реестре запись, похожую по ключевым словам, и включила её в биографию, не сверив совпадение личности. Другая система нашла похожий по названию знак у третьего юрлица и корректно пометила его как «вероятно, не связанный» — это методологически честнее, но само по себе показывает: без дополнительной ручной проверки даже сильные модели путают однофамильцев и созвучные названия.
Ссылка на удалённую, но всё ещё проиндексированную страницу. При ручной проверке одной из ссылок в отчёте Gemini — на конкретный пост в сообществе ВК — страница оказалась недоступной. Вероятнее всего пост был удалён или скрыт уже после того, как его успели проиндексировать поисковые системы, а модель взяла ссылку из устаревшего индекса. Это типичная проблема устаревшей индексации.
И в том же отчёте — точное попадание. В этом же самом ответе система корректно определила прямого конкурента бренда и дала на него верную, рабочую ссылку — этот конкурент действительно обсуждался в исходном интервью. Получается, что в одном и том же тексте, в соседних абзацах, соседствуют нерабочая ссылка и точно подтверждённый факт — и поданы они абсолютно одинаковым, уверенным тоном, без каких-либо маркеров сомнения. Отличить одно от другого можно только вручную, перейдя по каждой ссылке.
Один факт — две разные версии. Две системы независимо нашли участие героини в мероприятии одного и того же вуза примерно в один период — но описали его по-разному: разное название программы, разный формат, разная заявленная тема. Это либо два разных эпизода, слитых источниками в один, либо один эпизод, пересказанный каждой системой со своими деталями.

Точность и уверенность — не одно и то же
Отдельное наблюдение касается связи между длиной ответа, тоном и достоверностью. Самый компактный из «подробных» отчётов оказался и самым категоричным по формулировкам — с прямыми утверждениями об экспертном статусе. Системы с втрое большим числом источников использовали заметно более осторожные формулировки и явно помечали недостаточно подтверждённые факты.
Вывод простой и, на мой взгляд, самый важный во всём эксперименте: достоверность не переносится на весь текст целиком. Она существует на уровне отдельного факта, а не отдельного ответа или отдельной системы. Доверять стоит не тому, «насколько уверенно написано», а тому, что можно лично перепроверить по первоисточнику.
Кейс: как один подкаст выстроил цифровой образ героини эксперимента
У этого исследования есть личный контекст. Подкаст, который стал главным источником почти для всех ответов нейросетей, — мой собственный проект. Мы записали с героиней эксперимента один выпуск и распространили его по 20 площадкам: видео, аудиоверсии, разбор в отдельной статье, анонс и расшифровки. Именно эта распаковка одного разговора на несколько форматов и площадок и стала тем самым «многоканальным следом», который нашли пять из шести нейросетей, обнаруживших бренд.
Один содержательный разговор, снятый и записанный один раз, но упакованный под разные площадки и форматы, способен создать AI-видимый профиль эксперта почти во всех крупных поисковых системах — без бюджета на классические СМИ и без месяцев работы над личным брендом вручную.
Но, как показал этот же эксперимент, у этого механизма есть обратная сторона: раз источник фактически один, любая неточность или маркетинговое упрощение в исходном разговоре автоматически тиражируется во всех производных отчётах как «подтверждённый факт», потому что независимой проверки в этой цепочке просто нет. Поэтому прежде чем рассчитывать на подкаст, интервью или любой другой формат как на инструмент цифрового следа, стоит понимать не только его силу, но и эту уязвимость.
Где публиковаться, чтобы вас видели ИИ-поисковики
Если сложить всё, что показал эксперимент, получается довольно конкретная карта приоритетов — не «постите больше», а «закрывайте разные типы источников осознанно».
Слой 1 — собственные площадки. Сайт оказался самым цитируемым источником из всех (5 из 8 систем) — это база, без которой ИИ-поиску часто попросту не за что зацепиться. Дальше по частоте — Telegram-канал и VK, у Instagram* в этой выборке цитируемость оказалась почти нулевой (нашла всего одна система из восьми), хотя сам профиль активно велся. Вывод: не все соцсети одинаково хорошо индексируются и пересказываются ИИ-поисковиками, и закрытые/менее краулинг-дружелюбные платформы стоит дублировать более открытыми форматами — например, текстовой версией того же контента на сайте или в Telegram.
Слой 2 — один содержательный разговор, размноженный по форматам. Это самый эффективный по соотношению «усилие / охват в ИИ-поиске» инструмент из всех, что мы увидели: одна запись интервью или подкаста, выложенная на видеохостинги, аудиоплатформы и в текстовом разборе, может занять до 8 строчек в источниках сразу у нескольких систем. Это реально работающая тактика для эксперта без бюджета на классические медиа. Важно понимать её ограничение — описано выше: пока это единственный источник, ИИ не отличит его от полноценной независимой медийности, и любая неточность в разговоре растиражируется вместе с фактами.
Слой 3 — независимые внешние упоминания. Именно этого слоя оказалось меньше всего: в нашей выборке — всего четыре по-настоящему независимых упоминания, каждое зафиксировано только одной системой из восьми. Это самый ценный и самый дефицитный тип источника: комментарий в отраслевом СМИ, упоминание на стороннем мероприятии, пост от организатора форума — то, что вы не публикуете сами и не полностью контролируете. Именно такие источники в перспективе отличают устойчивую репутацию эксперта от медийного пузыря на одном интервью.
Слой 4 — реестры и официальные данные. Это единственный слой, который не требует никаких публикационных усилий: данные ИП или юрлица попадают в открытые реестры автоматически, в момент регистрации бизнеса. И именно эти данные неожиданно оказались одним из самых надёжных источников во всём эксперименте — они совпали дословно у двух независимых систем. Единственное, на что здесь стоит обратить внимание, — это однозначная привязка названия бренда к юрлицу: если она нечёткая, ИИ-система может, как в нашем эксперименте, случайно приписать вам чужой товарный знак или чужую компанию с похожим названием, просто по совпадению ключевых слов в реестре.
На что ориентироваться: сайт и собственные соцсети — обязательный минимум, один хорошо задистрибутированный подкаст или интервью — самый быстрый способ занять место в ответах ИИ, но настоящую устойчивость репутации в перспективе дают именно независимые упоминания третьих лиц, которых пока труднее всего получить и проще всего недооценить.

Прежде чем формировать цифровой след — проведите аудит вашего личного бренда
Всё, что я описала выше, — это то, что видит ИИ, когда у эксперта уже есть хоть какой-то цифровой след, пусть даже основанный на одном источнике. Но у большинства людей, которые задумываются о личном бренде, на старте нет даже этого — есть интуитивное ощущение «надо бы этим заняться» и разрозненные обрывки активности в разных соцсетях.
Прежде чем осознанно формировать свой цифровой след — тот самый, который завтра будет пересказывать ИИ-поиск, — имеет смысл сначала честно понять, что уже наработано, а что нет. Для этого у меня есть конкретный инструмент — аудит личного бренда: разбор компетенций, ценностного предложения, аудиторий и ключевых сообщений, которые уже (или ещё нет) с вами ассоциируются.
Скачайте рабочую тетрадь «Аудит личного бренда», распечатайте её и проведите инвентаризацию профессионального и личного багажа самостоятельно — шаг за шагом, в своём темпе.
Это займёт у вас от одного до нескольких вечеров, но результат того стоит: вместо смутного ощущения «надо бы заняться личным брендом» у вас на руках окажется конкретная карта — что уже есть, что не используется и куда двигаться в первую очередь.
*Facebook и Instagram - запрещенные в России соцсети; принадлежат Meta, которая признана экстремистской организацией в России
АУДИТ ЛИЧНОГО БРЕНДА
Прежде чем формировать цифровой след — проверьте, что уже наработано
Скачайте бесплатную рабочую тетрадь «Аудит личного бренда» — и проведите инвентаризацию профессионального и личного багажа самостоятельно, шаг за шагом.